

IEEE 1588-2008: где критична точность?
2026-01-10
содержание
Часто слышу вопрос про PTP, и сразу все начинают говорить о наносекундах, о синхронизации в энергетике или на телекоммуникационных станциях. Это, конечно, важно, но создаёт ложное впечатление, что точность сама по себе — главная цель. На деле, ключевой вопрос всегда: ?а для чего??. Где эта точность из теоретической цифры в спецификации превращается в критический, ?железный? параметр, от которого система либо работает, либо нет. И вот здесь начинаются все нюансы, которые в документах часто опускают.
Не ?сколько?, а ?зачем?: контекст точности
Когда только начинал работать с 1588, думал, что главная задача — добиться минимального offset на выходе grandmaster’а. Потом столкнулся с реальным проектом — распределённая система сбора данных для физического эксперимента. Там были десятки АЦР, разбросанные на площади. Заказчик требовал синхронизацию в пределах 100 наносекунд. Добились мы этих цифр в лаборатории, на коротких медных линиях, с хорошим оборудованием. Но на объекте… началось.
Первая же проблема — несимметричность задержек в fiber-оптических линиях, которые использовались из-за больших расстояний. Одно дело — расчёт в теории, другое — когда у тебя патч-корды разной длины, разные типы коннекторов, и, что самое неприятное, разная температура в разных частях кабельного канала. Это вносило переменную ошибку, которую не отфильтруешь простым PTP. Пришлось заказывать специализированные медиаконвертеры с поддержкой прозрачных часов (Transparent Clock), что резко удорожило проект. Точность стала критична не на уровне протокола, а на уровне физического слоя, и это был первый важный урок.
Ещё один момент, который часто упускают из виду — это джиттер и вандэр на самом slave-устройстве. Можно иметь идеальный мастер и сеть, но если тактовый генератор на приёмной плате дешёвый и с высокой фазовой дрожью, все усилия насмарку. Видел случаи, когда инженеры пытались сэкономить, используя стандартные промышленные компьютеры со встроенными сетевыми картами. PTP-демон работал, но реальная точность между двумя такими slave’ами плавала в микросекундном диапазоне, хотя по логи протокола всё было ?ок?. Критична точность оказалась в точке приёма времени, а не его передачи.
Энергетика: где микросекунды решают
Здесь, пожалуй, самый жёсткий и понятный пример. Речь о синхронизации устройств РЗА (релейной защиты и автоматики) на разных концах линии электропередачи. Для корректной работы дифференциальной защиты нужно, чтобы замеры тока и напряжения в точках А и Б были привязаны к единому времени с ошибкой, обычно, меньше 1 микросекунды. Не нано, а именно микро — но это должно быть гарантировано в 100% случаев, при любых сетевых событиях, переконфигурациях.
Работал с одной подстанцией, где внедряли цифровую РЗА на базе МЭК 61850 с синхронизацией по PTP (профиль power profile, IEEE C37.238). Всё шло хорошо, пока не произошло переключение на резервный grandmaster. По логике, всё должно работать. Но случился сбой — на несколько секунд точность вышла за допустимые пределы. Причина? Резервный мастер был подключен через другой коммутатор, у которого была включена функция IGMP snooping, но неправильно сконфигурированы таймеры. При переключении образовалась задержка в построении multicast-дерева для PTP-пакетов. Система защиты, к счастью, перешла в блокировку по признаку потери синхронизации, а не выдала ложное срабатывание. Но осадок остался: критична не только статическая точность, но и её устойчивость, живучесть при отказах. Тут каждый микросекундный выброс — потенциальное отключение энергии или повреждение оборудования.
Интересно, что в таких системах часто используют гибридный подход: PTP для постоянной синхронизации и IRIG-B или даже GPS-метки как резерв или для начальной привязки. Это тот случай, когда надёжность системы важнее абсолюта в одном протоколе.
Телеком: между fronthaul и backhaul
В телекоме всё стало особенно интересно с приходом 5G и архитектуры Cloud RAN. Здесь PTP должен обслуживать две разные по требованиям области: синхронизацию базовых станций в сети backhaul (точность в десятки микросекунд для TDD) и сверхжёсткие требования сети fronthaul между распределёнными и центральными блоками (eCPRI требует синхронизацию фазы несущей, тут уже речь идёт о десятках наносекунд).
Был вовлечён в пилотный проект по развёртыванию небольшой сети. Самым сложным оказалось не настроить grandmaster, а обеспечить выполнение требований по точности через каскад сетевого оборудования от оператора. Часто арендованные линии проходят через непрозрачные для PTP облака провайдера. Приходится либо договариваться о выделенном сервисе с поддержкой SyncE и PTP, либо ставить свои устройства на границах. Критичность точности здесь упирается в экономику: аренда ?синхронизированного? канала может быть в разы дороже.
Также столкнулся с курьёзной проблемой на одной базовой станции. Slave-устройство показывало отличную точность, но при этом периодически срывалась передача данных. Оказалось, что сетевая карта, получая PPS-сигнал от PTP-модуля, корректировала системные часы слишком агрессивно, что влияло на планировщик процессов в реальном времени. Пришлось тонко настраивать алгоритм дисциплины часов (clock servo). Это пример того, как точность временной метки может конфликтовать с общей стабильностью системы.
Промышленная автоматизация: скрытая сложность
Казалось бы, тут требования мягче — где-то от микросекунд до миллисекунд. Но именно здесь PTP сталкивается с самой неидеальной средой. Длинные цепи на заводском цеху, наводки от силового оборудования, коммутаторы в некондиционируемых шкафах, вибрация. Точность становится критичной не для скорости, а для корреляции событий. Например, чтобы точно установить последовательность срабатывания датчиков на конвейере или определить, какой из клапанов открылся первым при аварийной остановке.
Помню проект на автомобильном заводе, где синхронизировали несколько высокоскоростных камер для контроля качества сварки. Использовали проприетарный протокол одного вендора, но решили перейти на стандартный PTP для унификации. Столкнулись с тем, что сетевой трафик от самих камер (огромные потоки видео) создавал джиттер и периодические задержки в очередях коммутаторов. PTP-пакеты терялись или задерживались. Решение было не в настройке PTP, а в правильной сегментации сети и приоритизации трафика (QoS). Критичная точность была достигнута только после того, как мы изолировали синхронизацию в отдельном VLAN с высшим приоритетом.
Ещё один аспект — это массовый deployment. Когда у тебя не десять, а тысяча устройств, требующих синхронизации, важна не только точность одного, но и консистентность точности всех. Разброс (asymmetry) между разными slave’ами в разных частях сети может свести на нет пользу от синхронизации. Иногда проще и надёжнее в таких кластерах использовать не pure PTP, а его комбинацию с синхронизацией по триггерным линиям или через выделенные шины.
Аппаратная основа: без железа никуда
Всё, о чём говорил выше, упирается в ?железо?. Можно сколь угодно хорошо настроить софт, но если аппаратная платформа не обеспечивает детерминированность, точность будет условной. Ключевые элементы: тактовый генератор (OCXO, TCXO), схема выделения тактовой частоты из Ethernet-сигнала (SyncE), наличие аппаратного временистемпинга (hardware timestamping) прямо на сетевом PHY.
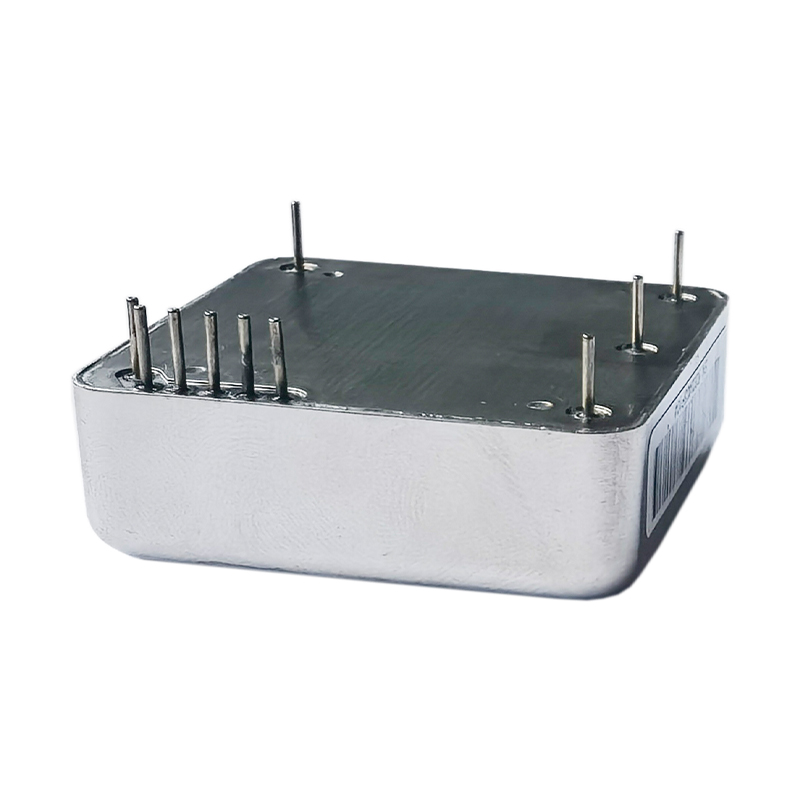
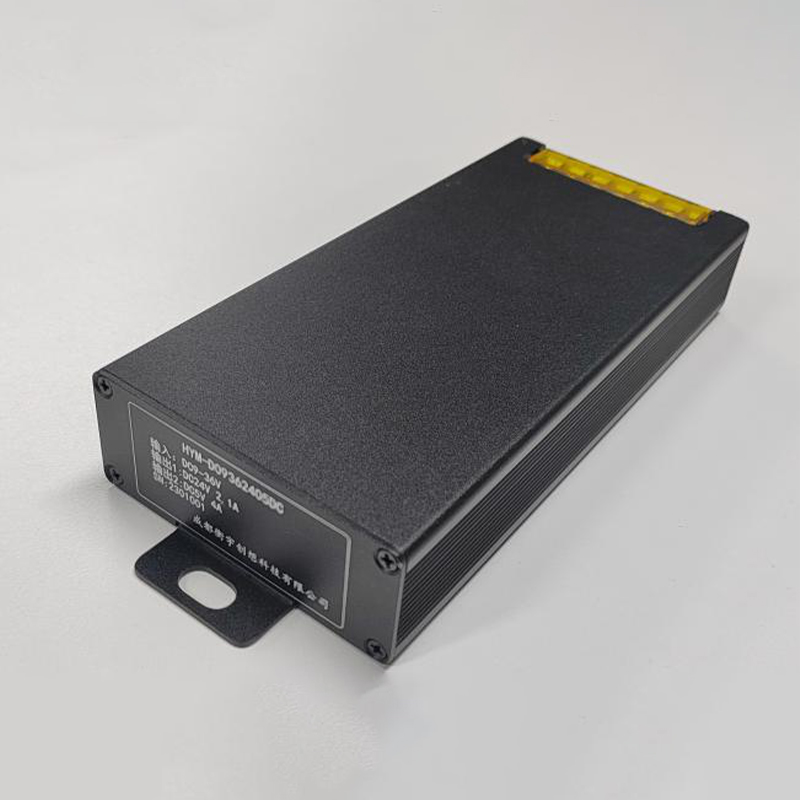
Здесь, кстати, часто ищут готовые решения, чтобы не разрабатывать с нуля. На рынке есть специализированные производители, которые фокусируются именно на компонентах для синхронизации. Например, компания ООО Чэнду Хэнюй Чуансян Технология (https://www.cdhycxs.com) как раз предлагает частотно-временные модули и платы, оборудование для систем измерения времени. В их ассортименте есть продукты, которые могут служить и как grandmaster, и как slave-устройства с высокой стабильностью. Для инженера, который собирает систему, такой модуль — это готовый, отлаженный блок, который снимает головную боль с проектирования платы с нуля, подбора компонентов и борьбы с фазовым шумом. Особенно это актуально для нишевых применений, где нужна кастомная логика поверх стабильного временного ядра.
Сам использовал в одном из проектов внешний частотно-временной модуль от подобного вендора (не этой конкретной компании) для синхронизации измерительного стенда. Задача была — привязать данные с нескольких генераторов сигналов и анализаторов спектра. Пробовали сначала через NTP со встроенным сервером в контроллере — нестабильно. Перешли на PTP с софтовым timestamping — лучше, но джиттер был высоким. Только после внедрения платы с аппаратным временемстемпингом и хорошим осциллятором удалось добиться необходимой консистентности измерений. Это был наглядный урок: протокол — это логика, но физика тактового сигнала — это фундамент.
Выбор между ?сделать самому? и ?купить готовый модуль? часто сводится к компромиссу между стоимостью, временем разработки и требуемыми характеристиками. В высокоточных приложениях, где критична каждая наносекунда стабильности, готовые модули, подобные тем, что делает ООО Чэнду Хэнюй Чуансян Технология, часто оказываются экономически оправданным выбором, так как они уже прошли весь цикл отладки и верификации характеристик, которые заявлены.
Итог: точность как системное свойство
Так где же всё-таки критична точность в IEEE 1588? Мой опыт подсказывает, что не в конкретной цифре из стандарта, а в её гарантированности и системности. Это точка, где сходятся: корректная реализация протокола, правильно спроектированная сетевая инфраструктура, качественное аппаратное обеспечение и, что очень важно, понимание конечной задачи.
Можно потратить кучу ресурсов, чтобы ?выдавить? из системы субнаносекундную точность в идеальных условиях, но если при первой же переконфигурации сети или отказе компонента эта точность ?поплывёт? на микросекунды, то вся работа насмарку. Критична она там, где её отсутствие или нестабильность приводит к реальному, измеримому ущербу: ложному отключению линии электропередачи, потере пакетов в сети мобильной связи, браку на производственной линии или некорректным научным данным.
Поэтому, когда спрашивают про IEEE 1588, я теперь всегда уточняю: ?А что будет, если точность будет не 100 наносекунд, а 150? И как часто такое может случиться??. Ответ на этот вопрос и определяет, насколько критична точность в каждом конкретном случае. Всё остальное — технические детали, которые, конечно, важно знать и уметь настраивать, но которые всегда должны быть подчинены этой системной цели.